人工智能模型的競爭,過去很容易被理解成一場參數規模競賽:模型愈大、運算愈多,能力便愈強。
Qwen3.8-27B展示的卻是另一條路。
它只有約278億參數,遠小於許多閉源旗艦模型,也沒有依靠Mixture-of-Experts架構把總參數推上數千億甚至數萬億。它是一個每次推理都會動用整個模型的Dense模型,但按照Qwen官方公布的結果,它在部分軟件工程、長時辦公、指令遵循與電腦操作測試中,已追上甚至超越表中的Opus 4.6 Max。
真正值得記住的,不是「小模型打敗大模型」這種過度簡化的口號,而是:
當一個27B模型開始承擔閉源旗艦級工作,參數規模已不再是能力邊界最可靠的指標。
27B究竟做到甚麼?
Qwen3.8-27B最突出的地方,不是一般知識問答,而是Agent與軟件工程能力。
與上一代Qwen3.6-27B相比,Qwen3.8-27B在Terminal-Bench 2.1由63.4升至73.0,增加9.6分;SWE-bench Pro由53.5升至61.7,增加8.2分;NL2Repo由36.2升至42.3,增加6.1分。DeepSWE 1.1更由13.3升至42.2,達到上一代的3.17倍;Qwen自家QwenSWEBench則由49.3升至79.0,增加29.7分。
這些測試的共同點,是要求模型處理比「回答一道程式題」更完整的任務。它需要閱讀現有程式庫、理解檔案之間的關係、操作終端、修改程式、執行測試,再根據錯誤訊息修正方案。衡量的不只是模型能否產生一段看似合理的程式碼,而是它能否把工作真正完成。
Agent能力的提升同樣明顯:
CoWorkBench長時辦公工作由61.0升至70.7,增加9.7分。
JobBench專業工作由21.8升至33.4,增加11.6分,相對提升約53%。
Agents’ Last Exam的Pass@1由10.6升至20.4,接近翻倍;總分由27.3升至42.9,增加15.6分。
這意味着Qwen3.8-27B的進步,不只是更懂得回答問題,而是更能維持一段任務:規劃下一步、使用工具、讀取環境回饋、發現錯誤,再繼續完成工作。
它真的超越閉源旗艦嗎?
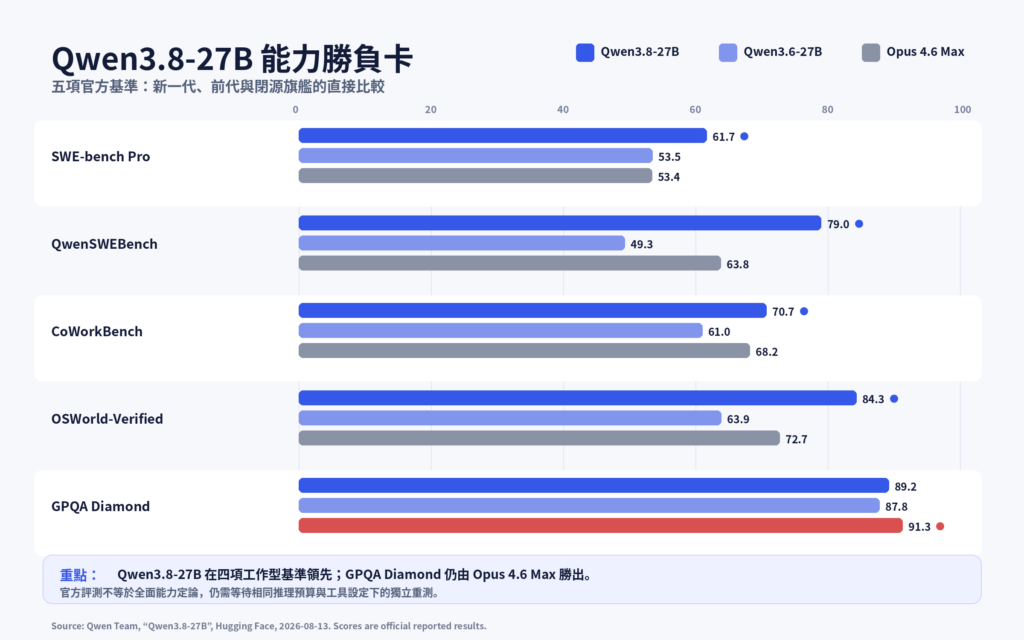
Qwen官方比較表把Qwen3.8-27B與Qwen3.6-27B、Qwen3.7-Plus、Muse Glimmer-30B及Opus 4.6 Max放在一起。最具新聞性的地方,是這個27B Dense模型在若干項目超越表中的Opus 4.6 Max:
| 測試 | Qwen3.8-27B | Opus 4.6 Max | 差距 |
|---|---|---|---|
| SWE-bench Pro | 61.7 | 53.4 | Qwen領先8.3分 |
| QwenSWEBench | 79.0 | 63.8 | Qwen領先15.2分 |
| CoWorkBench | 70.7 | 68.2 | Qwen領先2.5分 |
| IFBench | 79.5 | 62.5 | Qwen領先17.0分 |
| LiveCodeBench v6 | 90.3 | 88.8 | Qwen領先1.5分 |
| OSWorld-Verified | 84.3 | 72.7 | Qwen領先11.6分 |
| AndroidWorld | 81.9 | 62.0 | Qwen領先19.9分 |
| SWE-MM | 38.6 | 27.1 | Qwen領先11.5分 |
在OSWorld-Verified與AndroidWorld這類電腦及手機操作測試中,模型不只需要理解指令,還要觀看畫面、辨認介面元素、執行多步操作並處理途中出現的變化。Qwen3.8-27B在這些項目的表現,反映它正在由「生成答案的模型」轉向「能夠在數碼環境中行動的模型」。
不過,這不代表它已全面勝過Opus 4.6 Max。
Qwen3.8-27B在Terminal-Bench 2.1取得73.0,仍低於Opus的78.2;NL2Repo為42.3,低於47.6;GPQA Diamond為89.2,亦略低於91.3。代表高難度綜合推理的HLE差距更明顯,Qwen為30.8,Opus則為40.0。
較準確的說法是:Qwen3.8-27B尚未成為全面最強模型,但它已在若干與實際工作高度相關的Agent、編程及電腦操作測試中進入閉源旗艦級範圍,其中部分取得領先。
還要注意,這批數字主要來自Qwen官方公布的測試。部分基準由Qwen建立,個別評分亦使用其他模型作裁判;不同模型未必採用完全相同的工具框架、推理預算及測試設定。因此,這些結果足以顯示能力方向,卻不應被包裝成已獲全面獨立證實的「擊敗所有閉源模型」。
四代演化:模型沒有變大,工作卻愈做愈長
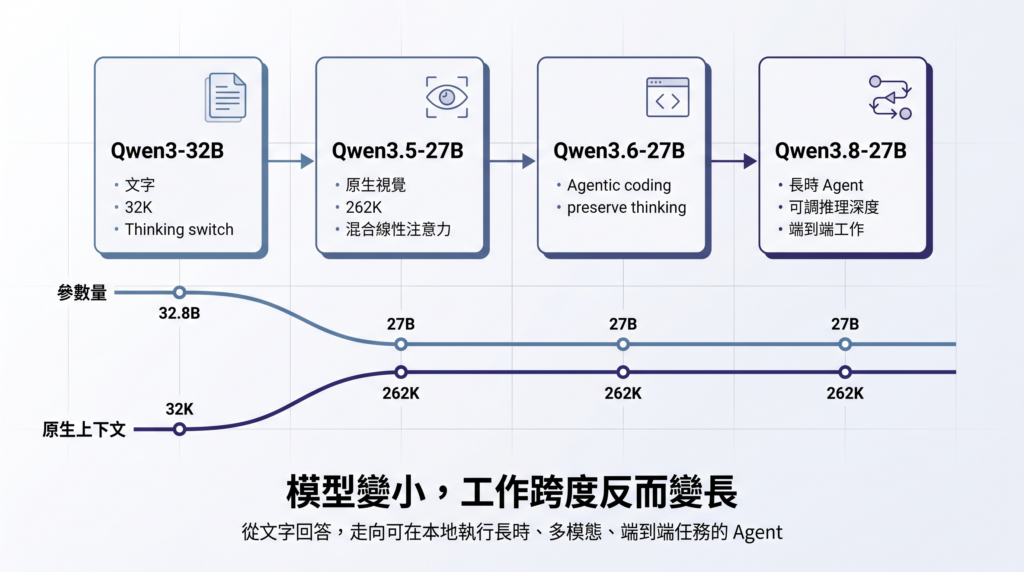
要理解Qwen3.8-27B為何重要,可以由Qwen3-32B這條Dense路線看起。
Qwen3-32B:把思考模式帶進Dense模型
Qwen3-32B共有32.8B參數,是一個以文字為核心的Dense模型。它把思考與非思考模式放進同一模型:複雜推理可以使用較長的思考過程,簡單問題則可直接回答。它亦支援超過100種語言、工具調用和Agent工作。
不過,這一代仍採用較傳統的Transformer注意力架構,原生上下文為32,768 tokens,透過YaRN可延伸至131,072 tokens。它已具備Agent的雛形,但主要角色仍然是文字推理模型。
Qwen3.5-27B:由文字模型變成多模態Agent基礎
Qwen3.5-27B把參數由32.8B降至約27B,能力範圍卻明顯擴大。
它加入原生視覺編碼器,可以直接理解圖片與影片;架構亦改為Gated DeltaNet線性注意力與Gated Attention混合設計,並加入Multi-Token Prediction。這些改動一方面降低長序列推理的成本,另一方面提升生成速度。原生上下文更由32K提高至262K,模型亦透過大規模Agent環境進行強化學習。
Qwen3.5-27B的意義,是27B Dense模型不再只負責「讀文字和寫文字」,而是開始具備感知環境、理解長內容及調用工具的底層能力。
Qwen3.6-27B:由會寫程式,進化到理解程式庫
Qwen3.6-27B沿用相同的27B Dense混合架構,但把重點轉向真實軟件開發。
它改善前端工作流程、repository-level reasoning及Agentic coding,並加入preserve thinking,讓模型在多輪Agent任務中保留先前的推理內容,不必每一步都重新分析整個問題。
這項改變看似不及增加參數矚目,卻直接影響Agent的工作效率。真正的軟件開發不是一次生成答案,而是閱讀、修改、測試、除錯,再繼續修改。模型能否保留任務脈絡,往往比單次答題分數更重要。
Qwen3.8-27B:由完成一步,走向完成整段工作
Qwen3.8-27B延續27B架構,主要提升來自後訓練、Agent環境及推理策略的改善。
它把preserve thinking設為預設,並加入xhigh、medium及low三種reasoning effort,讓部署者可根據任務在能力、速度與運算成本之間作調整。優化焦點亦由程式生成進一步擴展至長時Agent、專業工作、電腦操作和跨模態軟件工程。
| 世代 | 規模與架構 | 原生上下文 | 主要轉變 |
|---|---|---|---|
| Qwen3-32B | 32.8B Dense、文字模型 | 32K | 思考/非思考雙模式、工具調用 |
| Qwen3.5-27B | 27B Dense、混合線性注意力、原生視覺 | 262K,可延伸至1M | 由文字LLM變成多模態Agent基礎模型 |
| Qwen3.6-27B | 延續27B混合架構 | 262K,可延伸至1M | 強化程式開發、程式庫理解及歷史推理保存 |
| Qwen3.8-27B | 延續27B架構、改進後訓練 | 262K,可延伸至1M | 強化長時Agent、專業工作及端到端任務完成率 |
四代模型放在一起,最清楚的趨勢並不是參數愈來愈多,而是模型能處理的工作單位愈來愈大:由一次回答,到理解一個程式庫,再到持續執行一段完整任務。
「開源」還是「開放權重」?
Qwen3.8-27B採用Apache 2.0授權,容許商業使用、修改及再分發,對企業私有部署相當友善。
不過,嚴格而言,把它稱為「開放權重模型」比「完全開源AI」更準確。使用者可以下載、量化、微調及重新部署權重,但Qwen並未公開完整訓練資料、全部資料處理流程,以及足以由零開始重現模型的完整訓練配方。
這個區別並非文字遊戲。Apache 2.0主要回答「企業可否使用和修改模型」;完整訓練透明度回答的,則是「外界能否完全追溯模型如何形成」。兩者屬於不同層次的開放。
這對本地AI意味甚麼?
Qwen3.8-27B最值得關注的,不只是它在某些排行榜上取得高分,而是它重新界定了消費級本地AI可以承擔的工作。
過去提到本地模型,最常見的理由是私隱:資料不用傳送到第三方伺服器。如今,討論開始轉向能力與自主性:個人、小型企業或專業團隊,能否在自己控制的硬件上,擁有一套足以分析程式庫、閱讀內部文件、操作工具並持續完成任務的智能系統。
這尤其適合幾類使用者:
軟件開發者及DevOps團隊:分析私人程式庫、重構程式、生成測試、操作終端及建立內部coding agent。
專業服務機構:在不把客戶文件交給第三方API的前提下,處理審計底稿、合約、財務資料及研究文件。
企業知識管理團隊:建立本地RAG、文件搜尋及多步研究工作流程。
AI研究及產品團隊:測試工具調用、MCP、瀏覽器操作、computer use及長時Agent。
內容與創作團隊:分析圖片、影片與長文件,建立具人工覆核的內容工作流程。
若用途只是一般問答、翻譯或短篇摘要,7B至14B模型通常更快、更省電,也更容易維護。Qwen3.8-27B的價值主要出現在資料需要留在本地,而且任務複雜度足以使用其Agent和長上下文能力的情況。
最後一個驚喜:一張24GB顯卡便可部署
Qwen3.8-27B的能力已令人注目,但它最終能否改變實際應用,仍取決於普通使用者能否把它部署起來。
答案是:經常用的4-bit量化後,可以。
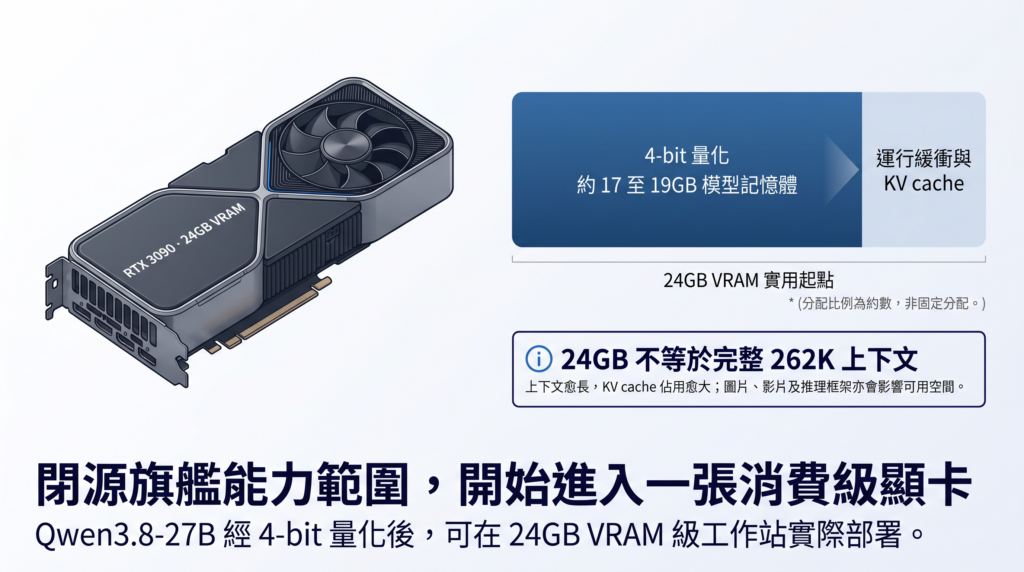
Qwen3.8-27B的4-bit量化版本約需17至19GB RAM或VRAM。換言之,一張擁有24GB VRAM的RTX 3090、RTX 4090或同級顯卡,已可把模型完整放入顯存,並留下部分空間給運行緩衝及KV cache。
RTX 3090因此成為一個很有記憶點的例子。這是一張於2020年推出的消費級顯卡,到了2026年,仍能承載一個具備視覺、影片理解、推理、程式開發與Agent能力的27B模型。
不過,「模型能放進24GB顯存」不代表可以同時用盡官方標示的262,144 tokens原生上下文。權重只佔記憶體的一部分;輸入愈長,KV cache佔用愈大,圖片及影片亦會增加記憶體需求。對24GB顯卡而言,8K至16K上下文是較穩妥的起點;能否提升至32K或以上,取決於推理框架、KV cache量化、視覺模組與GPU卸載設定。
若要長期處理大型程式庫、數百頁文件或長影片,32GB統一記憶體或VRAM只算較實用的起點,48至64GB會更從容。大量併發服務、完整262K至1M上下文或高精度部署,則仍需要專業GPU、多卡伺服器或雲端推理平台。
因此,硬件結論可以濃縮成一句:
24GB VRAM是Qwen3.8-27B 4-bit單卡部署最有代表性的實用起點,而不是所有使用情境的終點。
當一個能在部分Agent測試超越閉源旗艦的模型,可以在一張消費級顯卡上運行,本地部署便不再只是愛好者實驗。它開始成為企業架構中的另一種選擇:不是把所有智能交給雲端,而是在私隱、成本、延遲、能力與控制權之間重新劃界。
但本地運行並沒有消除責任。模型可以離線部署,不代表輸出可靠;模型能調用工具,不代表應取得無限制權限;模型可以操作桌面,也不代表可以跳過審批、日誌、沙盒與人工覆核。
Qwen3.8-27B把前沿級能力帶到個人工作站。下一個問題已不再是「普通人能否擁有一個強大的AI」,而是:當強大的AI真正進入普通人的電腦,我們準備給它多大的權限?