機器能思考嗎?七十六年後重讀圖靈
從模仿遊戲到大型語言模型,我們是否一直問錯了問題?
1950年,Alan Turing在學術期刊《Mind》發表〈Computing Machinery and Intelligence〉,以一句後來改變人工智能史的問題開始:
“Can machines think?”
「機器能思考嗎?」
然而,Turing沒有急於回答「能」或「不能」。他首先懷疑的,反而是問題本身。
「機器」是甚麼?「思考」又是甚麼?如果只能根據日常用法界定兩者,我們是否要像進行民意調查一樣,以多數人的語言習慣決定機器有沒有思想?Turing認為,這樣做不但不能澄清問題,反而會把問題困在尚未穩定的概念之中。
因此,他作出了一個關鍵轉向:與其先決定思考的本質,不如把問題換成一個能夠觀察和實驗的遊戲。
這個轉向究竟是一種逃避,還是一種面向未知的研究方法?七十六年後,當大型語言模型已能生成流暢文字、參與複雜對話,甚至在特定短時間文字測試中令提問者更常把它選為真人,這個問題比以往任何時候都更值得重讀。
被簡化的模仿遊戲
今天人們提到「Turing Test」,通常想到這個版本:一名人類透過文字,分別與另一名人類及一台機器交談;如果他不能可靠地分辨兩者,機器便被視為在這項測試中表現成功。
但這不是Turing在論文開首首先引入的版本。Turing先描述一場以性別辨認為目標的三人遊戲,其後讓機器取代其中一方;在後續論證與例子中,他亦採用了更接近今天所熟悉之人機辨認測試的表述。這些表述究竟構成同一測試的不同階段,還是彼此有別的版本,至今仍有不同的學術解讀。
原始開場的 imitation game 有三名參與者:
- A是一名男性,任務是令提問者判斷錯誤。
- B是一名女性,任務是協助提問者作出正確判斷;Turing認為,她的最佳策略大概是如實回答。
- C是身處另一房間的提問者,任務是判斷A與B誰是男性、誰是女性。
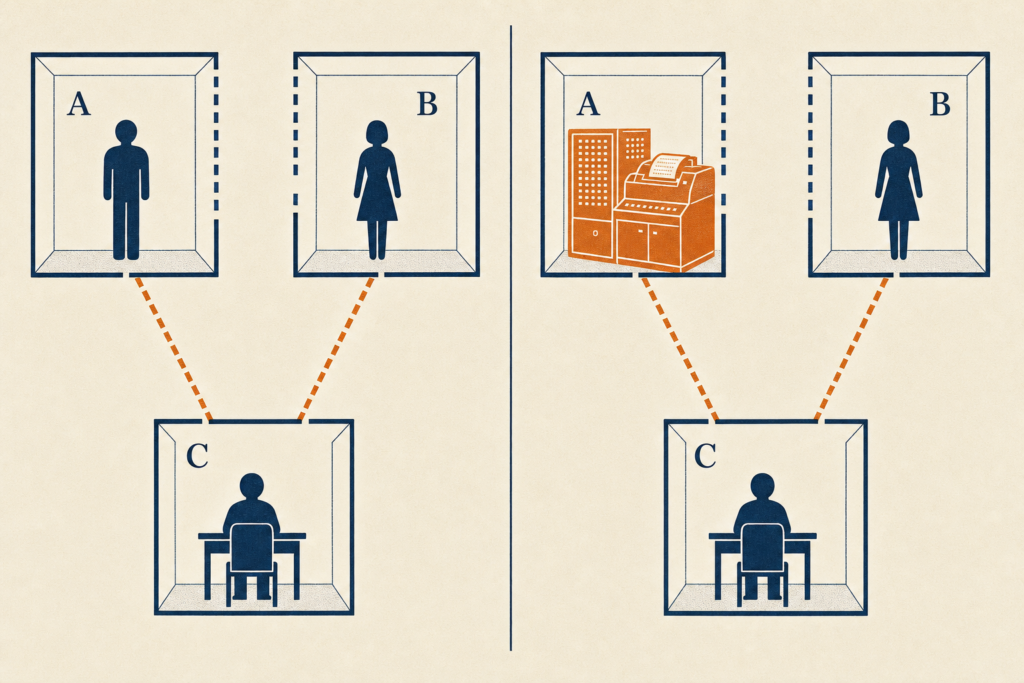
為了排除聲音、外貌與身體線索,所有問題和答案都以書面、打字機或電傳打字機傳送。男性可以聲稱自己是女性,女性也可以說「不要相信他,我才是女性」;但兩人的陳述在純文字中具有相同的表面形式。
Turing接着問:如果由一台機器取代A,提問者會否像原來分辨男性與女性時一樣經常判斷錯誤?
至少在論文開首的字面安排中,機器取代的是原本負責誤導提問者的A;這使欺騙、模仿與身份判斷從一開始便成為遊戲的一部分。
後來形成的「標準Turing Test」,往往淡化了原始遊戲中的性別安排,也把Turing不同段落中的設計表述收束成一種較簡單的敘事:機器只要成功騙過人類,便證明它具有智能。
但這不是Turing原文所能直接推出的結論。
從本質轉向表現
Turing的做法可以理解為一種操作性轉換。他沒有先為「思考」建立終極定義,而是提出一個較清楚的替代問題:在限定的文字互動中,一台數碼電腦能否作出與人類難以區分的回應?
這種方法的價值,在於讓抽象問題進入可觀察的現實。
我們無法直接進入另一個人的意識,也無法從外部看見「理解」本身。日常生活中,我們相信他人具有思想,主要依靠的也是語言、行動、持續回應及共同情境。模仿遊戲把這種原本隱藏於日常交往中的判斷過程,變成一個可以分析的實驗。
但操作性定義同時是一種收窄。
一台機器可能以完全不同於人類的方式處理世界,卻因為不擅長模仿人類而在遊戲中失敗;另一台機器也可能非常擅長複製人類語氣,卻沒有穩定的世界模型、自主目標或任何可證明的主觀經驗。
因此,模仿遊戲最多告訴我們:在某些條件下,機器的語言表現已超出人類可靠辨認的範圍。它沒有直接告訴我們,機器內部發生了甚麼。
這正是Turing方法最有力量、也最需要謹慎理解的地方:它讓研究得以開始,卻不能代替所有後續問題。
七十六年後的實驗
Turing曾在論文中作出一項具體預測:大約五十年後,電腦將能把模仿遊戲玩得如此出色,以致一般提問者經過五分鐘提問後,作出正確判斷的機率不會高於70%。
這句話常被誤讀為「機器需要騙過70%的人才算通過」。實際上,Turing說的是人類正確辨認率不高於70%,亦即機器在約30%的情況下已足以造成誤判;而且這只是他的預測,不是他頒布的一套正式合格標準。
到了2026年,Cameron R. Jones與Benjamin K. Bergen在《Proceedings of the National Academy of Sciences》發表一項隨機、受控並預先註冊的三方Turing test研究。參與者同時與一名真人及一個語言模型進行最多約五分鐘的文字對話,其後必須判斷哪一方是真人。
在特定人類化角色提示(persona prompt)的條件下,GPT-4.5在73%的測試中被提問者選為真人;LLaMA-3.1-405B則為56%。在沒有相同persona設定時,GPT-4.5的比率下降至36%,LLaMA-3.1-405B則為38%。
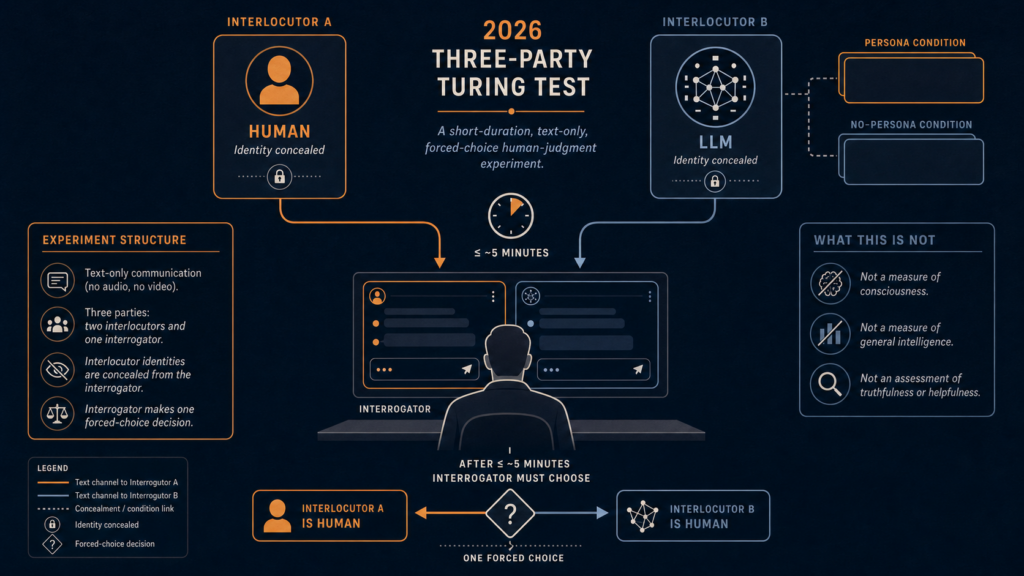
這些百分比是模型在該研究特定設計中被提問者選為真人的比率,不是一般性的智力分數,也不是理解、意識或智能的證據。它們同樣不能推廣至所有大型語言模型、所有提示條件、所有提問者,或更長時間的對話。
這個差異比「73%」本身更值得注意。
研究結果顯示,模型的優勢不只來自知識或推理能力。提問者的判斷經常受到語言風格、社交語氣、幽默、直接程度、錯誤及知識不足等線索影響;特定persona prompt則顯著提高了模型被判斷為真人的機率。
這並不表示每一項特徵都是模型成功的必要條件,也不代表研究已逐一證明它們的因果效果。但它提出了一個值得深思的可能性:一台機器要在這場遊戲中勝出,有時未必是因為它比人更聰明,而可能是因為它更有效地重現了人類在短暫文字互動中的社交特徵。
這也帶來另一個不安的問題:如果成功條件是被誤認為人,那麼測試獎勵的究竟是智能,還是欺騙能力?
能夠談論感受,等於感受到嗎?
Turing早已預見這項質疑。他引用神經外科學家Geoffrey Jefferson的反對:除非機器是因為真正感受到思想與情緒而寫出十四行詩或協奏曲,而不是讓符號偶然落下,否則不能說機器等同於心智。
這個問題在大型語言模型時代變得異常具體。
模型可以說「我感到難過」,可以描述恐懼、孤獨、期待,也可以討論自己的限制。但一個系統能夠生成關於感受的句子,是否表示它正在感受?語言表現是否只是對人類文本中情感模式的精密延續?
這個區分後來亦出現在John Searle的「中文房間」思想實驗中:一個系統可能按照規則產生表面上正確的語言回應,但這是否足以構成理解,仍存在爭議。這不是對大型語言模型沒有理解的直接證明,而是提醒我們,正確輸出與語義理解之間仍需要額外論證。
Turing沒有宣稱模仿遊戲能證明意識。他的回應是:如果我們要求必須直接進入機器的主觀經驗才能承認它思考,同一標準也會使我們無法確定任何其他人具有意識。除了成為對方,我們沒有辦法直接感受對方的思想。
這是一個有力但不完整的回應。它指出「他心問題」同樣適用於人類,卻沒有證明機器一定具有主觀經驗。它只告訴我們,拒絕機器心智的標準如果過高,可能也會動搖我們承認他人心智的理由。
所以,能夠談論感受不等於已證明具有感受;但能夠持續、適切地談論感受,也不能僅因對方是機器而被毫無論證地視為毫無意義。
問題仍然開放。
機器只能服從命令嗎?
另一項著名反對來自Ada Lovelace。她談到Babbage的分析機時指出,分析機並不聲稱能創造任何事物;它只能完成我們知道如何命令它執行的工作。
在傳統程式設計中,這項反對看來直觀:程式的每條指令都由人寫下,輸出似乎不可能超越程式員放進去的內容。
但Turing注意到,人們經常被自己設計的機器所產生的結果驚訝。這不一定證明機器具有原創性,卻至少說明「設計者沒有預見某個結果」與「結果不是由系統產生」並非同一件事。
今天的大型語言模型令這個問題更加複雜。模型的架構、數據、訓練目標、獎勵訊號及提示詞都來自人類設計;但任何單一設計者都不可能預先寫下或預見模型的全部輸出。
然而,不可預見仍不等於自主創造。意外可能源於龐大組合空間、訓練資料中的潛在模式,也可能只是錯誤。要討論機器的創造力,還需要考慮新穎性、價值、意圖、選擇及對結果的理解,而不能只看輸出是否令人驚訝。
Turing真正前瞻的地方
Turing最有遠見的部分,也許不是模仿遊戲,而是論文後段的 learning machine。
他問:與其直接編寫一個完整的成人心智,為何不先建立一個較簡單的「兒童機器」,再透過教育使它逐步形成?
“Instead of trying to produce a programme to simulate the adult mind, why not rather try to produce one which simulates the child’s?”
「與其嘗試編寫模擬成人心智的程式,何不嘗試編寫一個模擬兒童心智的程式?」
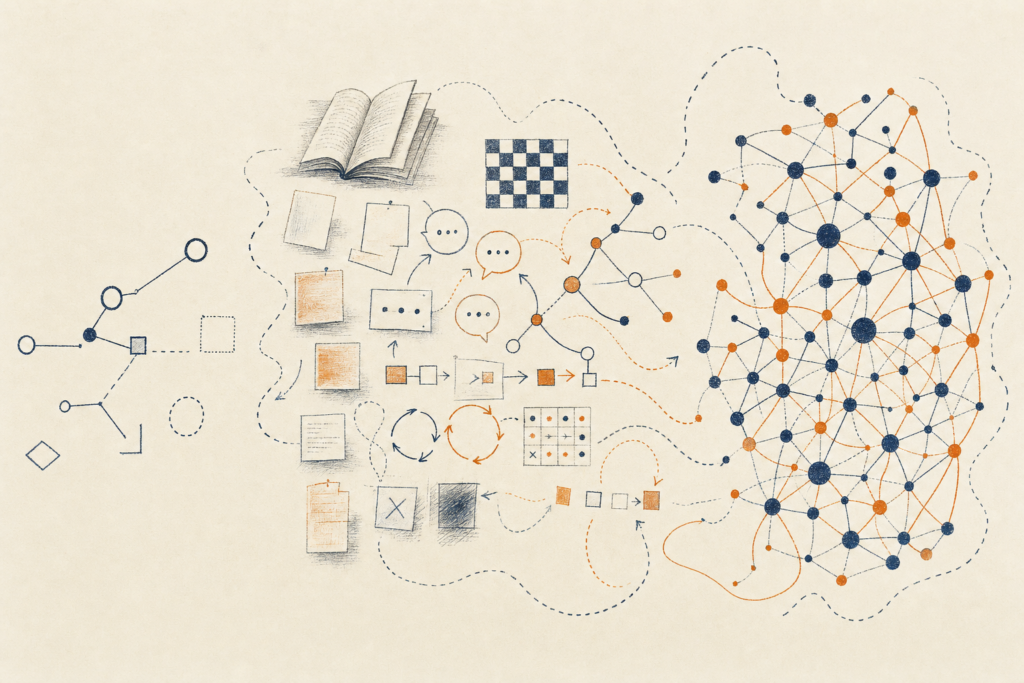
這個構想包含三個部分:兒童心智的初始狀態、接受的教育,以及在教育之外累積的經驗。Turing還討論了獎勵、懲罰、規則改變與試驗過程。
這些構想與後來的機器學習,尤其是以獎勵和懲罰調整行為的強化學習,具有明顯的概念親緣;但不能因此說Turing已提出現代監督學習、強化學習或大型語言模型的技術框架。他沒有提出Transformer、反向傳播、自監督預訓練或現代規模化定律。
真正值得保留的,不是「先知式預言」的戲劇性,而是他對智能形成過程的重視:智能不必被視為一套已完成、逐條寫入的規則,也可以被理解為教育、經驗、環境與修正共同塑造的過程。
如果智能是學習出來的,那麼評估一個模型時,便不能只看完成訓練後的對話表現。還必須追問:它從哪些資料學習?哪些行為受到獎勵?哪些聲音被排除?訓練者的價值、偏見和目的,如何進入模型?
這使智能問題從「它像不像人」延伸為「它如何成為現在的樣子」。
測試的也許一直是關係
模仿遊戲表面上測試機器,實際上需要至少三個位置:提問、回應與判斷。智能並不是被直接打開檢查的物件,而是在互動中,透過一連串語言、期待、誤解及修正而被辨認。
這並不表示智能只存在於關係之中,也不表示內部結構不重要。沒有模型架構、訓練資料、記憶與計算,就不會有相應的回應能力。但如果沒有提問者、共同語境與判斷標準,「通過」或「不通過」同樣不會發生。
因此,Turing留下的可能不是一把測量智能本質的尺,而是一面鏡子。
它映照機器能夠表現甚麼,也映照人類如何辨認智能;映照我們重視知識、邏輯與一致性,也映照我們原來會把幽默、猶豫、錯誤和社交節奏視為「像人」的證據。
當特定條件下的大型語言模型在短暫文字測試中,比與它配對的真人更常被選為真人,改變的不只是機器的能力邊界,也包括人對自己的想像。
由玄想出發,向無涯而行
FFOO Labs相信:
由玄想出發,向無涯而行;在想像與實踐之間,探索人與智能交會的無名未形之境。
重讀Turing,最重要的也許不是替「機器能思考嗎?」找一個新的標準答案,而是理解一個問題在尚未能被清楚定義時,如何仍然可以被研究、實驗與反思。
Turing沒有讓定義停留在純粹玄想之中。他設計思想實驗,界定技術條件,提出可檢驗的預測,再面對神學、數學、意識、原創性與學習等反對意見。想像使問題保持開放,實驗則讓問題在現實中顯形。
但任何操作性定義都有邊界。當模仿遊戲把「思考」轉化為「在文字互動中無法被分辨」,它同時照亮了一部分問題,也遮蔽了意識、具身經驗、自主性、長期一致性與倫理責任。
不以已知限制未知,不等於放棄準確性;不急於固定智能的定義,也不等於可以把語言流暢度直接稱為理解,把人類誤判直接稱為意識。
真正開放的探索,必須容許兩件事同時成立:大型語言模型已經展現出足以改變人類互動的語言與社交模仿能力;而這些能力究竟構成哪一種智能,仍需要更嚴格、更長期及更多元的研究。
七十六年後,機器是否已經能夠思考,也許仍沒有一個所有人都接受的答案。
但Turing留下了一個更耐久的方法:不要讓尚未完成的定義阻止探索,也不要讓一次成功的實驗過早終結問題。
在提問、回應與判斷之間,人與智能仍在彼此映照。那個尚未被命名、尚未形成的關係,或許才是模仿遊戲至今仍未結束的原因。
參考資料
- Turing, A. M. (1950). “Computing Machinery and Intelligence.” Mind, 59(236), 433–460. Oxford Academic
- Jones, C. R., & Bergen, B. K. (2026). “Large language models pass a standard three-party Turing test.” Proceedings of the National Academy of Sciences, 123(21), e2524472123. PNAS
- Oppy, G., & Dowe, D. “The Turing Test.” Stanford Encyclopedia of Philosophy. Stanford Encyclopedia of Philosophy
- Cole, D. “The Chinese Room Argument.” Stanford Encyclopedia of Philosophy. Stanford Encyclopedia of Philosophy