AI令知識平權,為何學生反而退步?26,811名學生研究揭示「理解不能外包」
AI降低了取得知識的成本,卻沒有同時免除形成理解所需要付出的努力。
人工智能本應是教育平權的重要工具。
過去,學生能否得到個別指導,往往取決於家庭能否負擔補習、學校是否擁有足夠資源,以及身邊有沒有一位願意耐心解答的老師。今天,只要擁有一部連接網絡的裝置,學生便可以要求AI解釋數學概念、比較歷史觀點、修改文章,甚至按照自己的程度與語言重新講解艱深知識。
一位優秀的私人老師未必是每個家庭都能負擔;一位知識廣博、能夠隨時回應的AI老師,卻可以近乎零邊際成本,同時服務無數學生。
照理說,當知識變得更容易接觸,學生應該學得更快、更廣、更深入。然而,一個反直覺的問題隨之出現:
如果AI讓每個孩子都可以以前所未有的低成本,隨時向一位知識廣博的老師提問,為甚麼研究看到的不是學生普遍學得更好,而是功課分數上升、考試成績反而下降?
一項追蹤26,811名中國中學生30個月的研究,正好呈現了這個矛盾。
AI明明降低了取得知識的門檻,為甚麼沒有自然轉化成更好的學習?
問題可能在於,我們把兩件看似相近、實際上並不相同的事情混為一談:接觸知識,與形成理解。
研究發現了甚麼?
這項研究名為 The Generative AI Learning Penalty: Evidence from Chinese Secondary Education,由David Strömberg、Victor Lei及Yanhui Wu撰寫,於2026年以CEPR Discussion Paper DP21577發表。
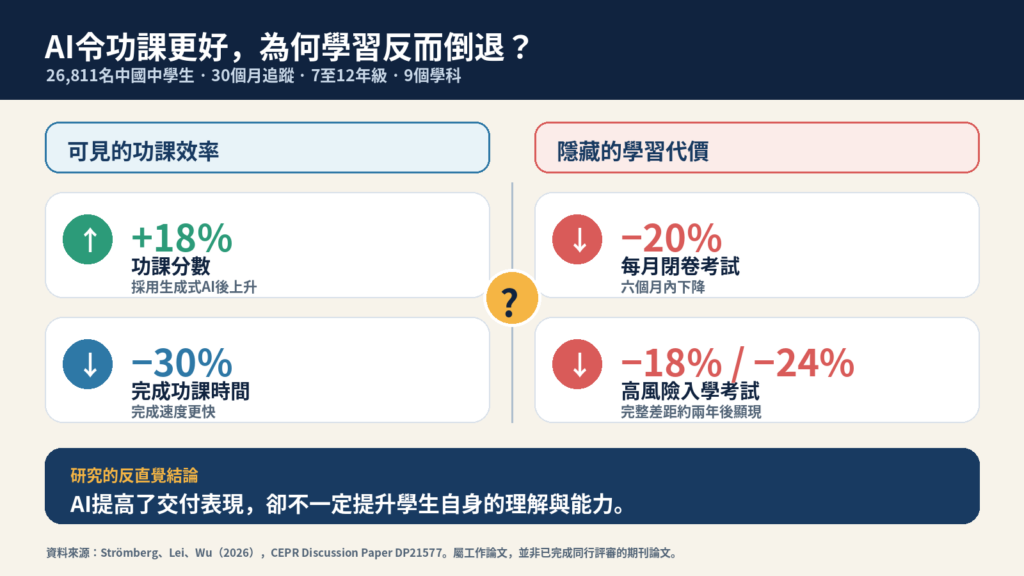
研究使用26,811名中國七至十二年級學生的30個月追蹤資料,涵蓋九個學科,包括功課分數、功課完成時間、每月閉卷考試,以及高中和大學入學考試成績。研究人員利用不同學生在不同時間開始採用生成式AI的情況,以交錯式差異中的差異法估計AI採用前後的變化。
結果非常矛盾:
- 採用生成式AI後,功課分數平均提高18%。
- 完成功課所需時間平均減少30%。
- 每月閉卷考試成績在六個月內下降20%。
- 兩類高風險入學考試成績分別下降18%和24%,完整的負面差距約在兩年後顯現。
學習損失在社會科學科目最大,其次是STEM科目和語言科;年級較低、原本成績較高的學生及男生所呈現的負面差距亦較大。
換言之,學生完成得更快,交出的答案看來更好;但當評估轉向學生自身的學習表現時,結果卻向相反方向發展。
不是「腦力衰退」
這些結果十分值得關注,但不應誇大成「AI令學生大腦退化」或「AI使孩子變笨」。
研究量度的是功課、完成時間與考試成績,沒有量度腦部結構、智力、注意力或其他神經認知指標。它支持的是一項關於學習表現與能力形成的警告,不能單憑這些資料推論學生出現生理上的「腦力衰退」。
同樣重要的是,這是一份CEPR工作論文,而不是已完成同行評審的期刊論文。研究雖然採用了縱向數據和準實驗方法,但並非把學生隨機分配到使用或不使用AI的實驗,因此仍可能存在無法完全排除的群組差異和其他同時發生的因素。
研究發生於中國中學教育環境,其考試制度、功課文化及AI使用方式亦未必能直接推廣至所有國家、年齡和學科。文中的百分比應被理解為這項研究在特定資料和模型下估計的平均結果,而不是每名學生使用AI後必然出現的變化。
問題在如何使用
這份研究最重要的細節,不是所有AI使用者都出現同樣程度的退步。
研究作者發現,負面結果主要集中於約80%的AI使用者。這些學生呈現出「功課外包」的行為特徵:他們在極短時間內完成作業,同時取得很高的功課分數。
相反,使用AI後仍維持與非AI使用者相若功課時間的學生,學習損失較小。
這種分類是研究人員根據完成時間與分數作出的行為推斷,並不代表研究能夠直接看見每個學生如何操作AI。不過,它提供了一個重要線索:
真正影響學習的,未必只是學生有沒有使用AI,而是AI取代了哪一部分活動。
假如AI被用來解釋概念、提出反例、比較觀點和指出盲點,它可能增加學生與知識互動的深度。假如AI被用來直接生成一份可以提交的答案,它所節省的便可能包括原本用來形成理解的練習。
理解不能外包
在Sequoia Capital的AI Ascent 2026訪談中,AI研究者Andrej Karpathy談到一句他認為概括得很好的說話:
“You can outsource your thinking, but you can’t outsource your understanding.”
「你可以外包思考,但不能外包理解。」
Karpathy在訪談中的原話帶有「大意如此」以及「這概括得很好」的語氣,因此較嚴謹的寫法,是說他在訪談中引用或強調了這個觀點,而不是斷言這句話最初由他創作。
這句話並非要求學生拒絕AI,也不是說所有思考都必須由人獨自完成。AI可以協助搜尋、整理、比較、計算和表達;真正不能直接轉移的,是人在這些活動中形成的理解。
一個答案可以在數秒內從AI出現在學生的螢幕上,但不會因而自動成為學生認知的一部分。學生可能覺得答案「看起來很明白」,卻未必能說明:
- 答案依據哪些事實?
- 推論經過哪些步驟?
- 當中預設了哪些條件?
- 還有沒有其他合理解釋?
- 哪些部分是事實,哪些是推論或價值判斷?
- 為甚麼應該相信這個答案?
因此,更適合教育情境的延伸是:
人可以與AI共同思考,但不能把形成理解的過程,以及判斷答案的責任,一併外判。
一位特殊的老師
AI可以是一位知識廣博、反應迅速,而且善於配合學生程度調整解釋的老師。但它也是一位十分特殊的老師:它可能記錯資料、遺漏條件、迎合提問者,甚至以流暢而自信的語氣講出錯誤答案。
美國國家標準與技術研究院NIST把這類現象稱為「虛構性生成」(confabulation):生成式AI可以自信地呈現錯誤或虛假的內容。NIST指出,這與生成模型按照訓練資料的統計規律產生內容有關;這種機制可以生成正確答案,也可能產生事實錯誤或前後不一致的內容。
所以,AI的語言流暢度並不等於可靠程度,自信語氣也不等於它掌握了證據。
同一個模型在不同使用方法下,答案品質也可以有明顯差別。問題定義是否清楚、有沒有提供必要背景、要求的是完整答案還是逐步提示、是否要求列出證據與不確定性,以及使用者有沒有持續追問,都可能改變人與AI互動的結果。
但這不代表掌握一套「完美提示詞」便能保證答案正確。好的使用方法只能增加答案的相關性、透明度和可驗證性,不能消除模型本身的錯誤風險。
不是AI必然有害
另一項接近1,000名高中數學學生參與的實地實驗,為這個問題提供了重要對照。研究結果於2025年刊登在美國國家科學院院刊《PNAS》。
研究人員設計了兩種GPT-4工具:
- GPT Base: 接近一般聊天機械人的自由使用方式。
- GPT Tutor: 加入教學護欄,引導學生逐步解題,減少直接索取答案。
學生使用工具練習時,GPT Base組的成績提高48%,GPT Tutor組提高127%。可是,在後續不再提供AI的評估中,GPT Base組的成績比從未使用AI的一組低17%;GPT Tutor組的負面學習效果則大致得到緩解。
這項研究說明:同樣使用GPT-4,「代替學生完成」與「引導學生學習」可能帶來截然不同的結果。
哈佛大學另一項隨機對照研究亦發現,經過教學設計的AI導師,可以令大學生在較短時間內取得比課堂主動學習更高的學習增益。這項研究於2025年在同行評審期刊《Scientific Reports》發表,DOI為10.1038/s41598-025-97652-6。
這些證據並不互相矛盾。它們共同指出,問題不能被簡化成「AI有利」或「AI有害」:
AI對學習的影響,很大程度取決於工具如何設計,以及學生如何與它互動。
理解也是使用前提
「不能外包理解」不只是指學生看過AI答案後,仍要明白答案。更深一層的問題是:理解不只是使用AI後希望獲得的結果,也是正確使用AI之前必須具備的能力。
學生愈理解問題,便愈能清楚說明目標、條件與限制;愈理解AI的本質,便愈不容易把流暢當成真確;愈理解答案的結構,便愈能辨認證據、假設和推論漏洞。
這形成兩種方向相反的循環:
| 被動依賴 | 主動理解 |
|---|---|
| 不理解問題便直接提問 | 先釐清問題、目標與限制 |
| 接收完整而流暢的答案 | 要求解釋、證據與不同觀點 |
| 把自信語氣當成正確 | 分辨事實、推論與不確定性 |
| 直接採用或提交答案 | 追問、比較、驗證與修正 |
| 更難判斷下一個答案 | 理解加深,更懂得使用AI |
因此,真正的AI素養不只是懂得寫提示詞,而是由四種理解組成:
- 理解問題: 我真正要處理甚麼?目標、條件和限制是甚麼?
- 理解AI: 它擅長甚麼?為甚麼可能出錯、迎合或產生偏差?
- 理解答案: 結論根據甚麼證據?經過甚麼推論?有哪些限制?
- 理解自己: 我為甚麼接受這個答案?我的目標和價值取捨是甚麼?
AI可以協助我們尋找達成目標的方法,但甚麼目標值得追求、願意承受甚麼代價,以及最後由誰承擔結果,仍然是人的問題。
父母應該問甚麼?
父母未必比孩子熟悉AI,也不需要先成為大型語言模型專家。比起只監察孩子有沒有使用AI,更重要的是培養孩子看待AI答案的態度。
以下問題可以成為家庭對話的起點:
- 你如何理解AI提出的答案?
- 這個答案建基於哪些資料和假設?
- AI在這裏提供的是事實、推論,還是意見?
- 有哪些部分你仍然不明白?
- 它可能遺漏了甚麼?
- 如果採用另一個角度,結論會否改變?
- 你根據甚麼判斷這個答案可靠?
- 你有沒有找到獨立資料支持或反駁它?
- AI的回答如何改變了你原本的理解?
- 你同意它的結論嗎?為甚麼?
其中,「你是否知道AI如何構建這個答案」可以稍為調整。學生通常無法從輸出得知模型內部真正的運算過程,AI自己事後生成的解釋也未必是其實際生成機制。
較準確的問題是:
你能否重構這個答案成立所需要的理由、證據、推論和假設?
目的不是要求孩子解釋模型的每一個參數,而是幫助他理解答案的知識結構。
知識平權不等於理解平權
現在可以回到文章開始的反問:如果AI降低了取得知識的成本,為甚麼學生的學習表現反而可能下降?
答案不是AI提供了太多知識,而是取得知識與形成理解,從來不是同一件事。
AI降低了搜尋資料、獲得解釋和產生答案的成本,卻沒有消除理解問題所需要的認知投入。當學生利用AI追問概念、比較觀點、檢查推論和發現盲點,它可以是一位優秀的老師;當學生只把問題交出去,再接收一份已完成的答案,它所節省的便可能包括原本用來形成理解的思考過程。
因此,這項研究不是證明AI與教育平權互相矛盾,而是在提醒我們:
AI實現的是知識接觸的平權;理解能否平權,仍然取決於教育。
AI可以讓更多孩子接觸同一份知識,但他們能否從中獲益,仍取決於是否理解問題、是否知道AI可能出錯,以及是否有能力判斷、追問和修正答案。
如果學校和家庭沒有教授這些能力,AI甚至可能產生一種新的教育差距:
過去的教育差距,可能在於誰有機會接觸一位好老師;未來的教育差距,則可能在於誰懂得理解、質疑和善用同一位AI老師。
未來教育的任務,不是把孩子留在一個沒有AI的舊世界,也不是讓他們毫無準備地接受AI生成的一切。我們需要讓孩子提早認識AI,理解它的能力與限制,並學會與它共同探索知識。
Karpathy強調的「理解不能外包」,不是要求人拒絕AI的幫助,而是提醒我們:只有理解,才能使人不被AI的答案支配;也只有理解,才能讓AI由一部代替人回答的機器,成為幫助人提出更好問題、作出更好判斷的老師。
當每個孩子都可以擁有一位知識比任何個人更廣博的AI老師,教育真正需要培養的,或許不再只是記住更多答案的人,而是一個懂得理解老師、質疑老師、修正老師,最終有能力超越老師的人。
研究資料
- Strömberg, D., Lei, V., & Wu, Y. (2026). The Generative AI Learning Penalty: Evidence from Chinese Secondary Education. CEPR Discussion Paper No. 21577. RePEc/CEPR論文資料
- Bastani, H., Bastani, O., Sungu, A., Ge, H., Kabakcı, Ö., & Mariman, R. (2025). Generative AI without guardrails can harm learning: Evidence from high school mathematics. Proceedings of the National Academy of Sciences, 122(26), e2422633122. DOI: 10.1073/pnas.2422633122
- Kestin, G., Miller, K., Klales, A., Milbourne, T., & Ponti, G. (2025). AI tutoring outperforms in-class active learning: an RCT introducing a novel research-based design in an authentic educational setting. Scientific Reports, 15, 17458. DOI: 10.1038/s41598-025-97652-6
- National Institute of Standards and Technology. (2024). Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile, NIST AI 600-1. NIST文件
- Sequoia Capital. (2026). Andrej Karpathy: From Vibe Coding to Agentic Engineering. 訪談影片